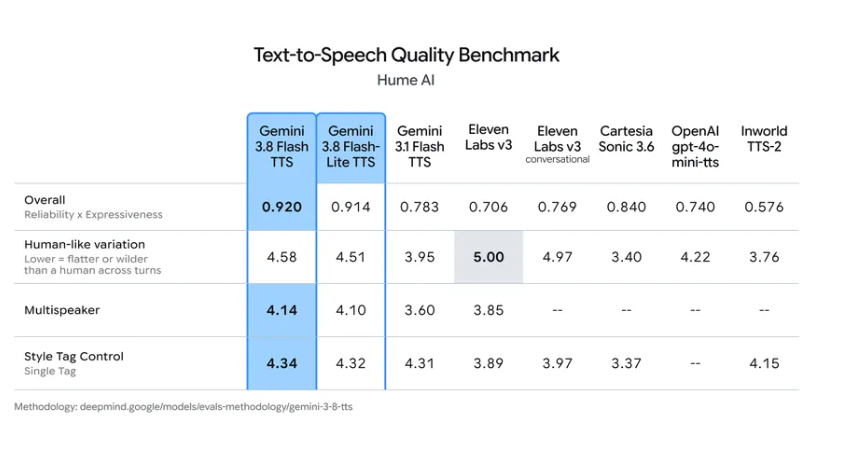
Google, konuşma üretimi için tasarladığı iki yeni model olan Gemini 3.8 Flash TTS ve Flash-Lite TTS’i tanıttı. Flash TTS metin tariflerinden yeni sesler üretebilirken, her iki model de 100’den fazla dili destekliyor ve kullanıcıların diyalog satırlarına sahne talimatları eklemesine imkan tanıyor.
Google’ın açıklamasına göre Gemini 3.8 Flash TTS oyun karakterleri, sesli kitaplar ve podcast’ler gibi yaratıcı projeler için tasarlandı. Gemini 3.8 Flash-Lite TTS ise dublaj, sesli içerikler ve sesli asistanlar için ölçeklenebilir, düşük maliyetli konuşma üretimine odaklanıyor.
Flash TTS, Kullanıcıların Metin Açıklamalarıyla Ses Oluşturmasını Sağlıyor
Gemini 3.8 Flash TTS ile kullanıcılar sıfırdan ses tasarlayabiliyor. Google, yazılı bir yönlendirmenin çok çeşitli dil ve lehçelerde bir sesin rolünü, aksanını ve vokal özelliklerini belirleyebildiğini ifade ediyor. Sıfırdan başlamak istemeyenler için Google, Meksika İspanyolcası, Quebec Fransızcası ve İskoç İngilizcesi gibi bölgesel varyasyonları da içeren 2.000’den fazla hazır sesten oluşan bir kütüphane sunuyor.
Ses klonlama özelliği, 30 saniyelik bir ses örneğinden bir ses profili oluşturabiliyor. Bu özelliği kullanmak için, sesi klonlanan kişinin açık rızasını belirten sesli bir ifade kaydetmesi gerekiyor ve bu kayıttaki sesin örnekle eşleşmesi şart koşuluyor. Gemini ses modellerinin ürettiği her klipte, YZ tarafından oluşturulan konuşmaların tespit edilmesine yardımcı olmak amacıyla duyulamayan bir SynthID filigranı bulunuyor.
Google ayrıca kullanıcıların kütüphanedeki seslerin tınısını, tonunu, temposunu ve aksanını ayarlamasına olanak tanıyacak “Voice Remixing” özelliğini de duyurdu fakat bu özellik henüz kullanıma sunulmadı.
Senaryo Yönergeleri, Diyalog ve Söyleyiş Üzerinde Kontrol Sağlıyor
Her iki model de kullanıcıların her satır için yönlendirme yazmasına veya modelin senaryodaki ipuçlarını kendi başına yorumlamasına izin veriyor. Google, modellerin zamanla ses karakteri bozulmadan saatlerce ses üretebildiğini, yani sesin akış boyunca neredeyse hiç değişmediğini söylüyor.
Şirkete göre çift ses modu, sesleri birbirinden ayrı tutarak tek bir senaryodan diyalog üretebiliyor. Kullanıcılar ayrıca tepkileri ve duraklamaları tam istedikleri yere yerleştirmek için gülme, iç çekme ve “hı-hım” gibi sesleri senaryolaştırabiliyor.
Google Her İki Modeli de Kullanıma Sunmaya Başladı
Google, her iki modeli de Gemini API ve Google AI Studio aracılığıyla erişime açıyor. Flash TTS ayrıca Gemini Notebook’ta yer alırken Flash-Lite TTS, Google Vids içinde sunuluyor. Google, Gemini Enterprise API aracılığıyla erişimin yakın zamanda her iki model için de sağlanacağını belirtiyor.
Agora, LiveKit, Pipecat ve Vercel dahil olmak üzere geliştirici platformları Gemini API entegrasyonunu şimdiden destekliyor. Önceki TTS modelleri AB veri işleme imkanı sunsa da Google, yeni modeller için henüz bölgesel uç noktaları listelemedi.
Google’ın aktardığına göre, ücretsiz katmandan gelen veriler ürünleri geliştirmek için kullanılırken ücretli katmandan gelen veriler kullanılmıyor. Ücretli fiyatlandırma, girdi için metin tokenları ve çıktı için ses tokenları faturalandırılacak şekilde milyon token başına ABD doları olarak listeleniyor.
| Ücretlendirme | Flash TTS (2026 sonuna kadar) | Flash TTS (2027’den itibaren) | Flash-Lite TTS (2026 sonuna kadar) | Flash-Lite TTS (2027’den itibaren) |
|---|---|---|---|---|
| Metin Girdisi | 0,50 $ | 1,00 $ | 0,50 $ | 1,00 $ |
| Ses Çıkışı | 9,00 $ | 18,00 $ | 6,00 $ | 12,00 $ |
Google, üretilen bir saniyelik sesin 25 ses tokenına eşdeğer olduğunu, bunun da bir saati 90.000 token yaptığını belirtiyor. Bu hesapla, 2026’nın sonuna kadar bir saatlik ses çıktısı Flash TTS ile 0,81 dolar, Flash-Lite TTS ile 0,54 dolar tutuyor. 1 Ocak 2027’de bu maliyetler sırasıyla 1,62 dolar ve 1,08 dolara çıkacak. Metin girdileri ise ayrıca ücretlendirilecek.
Kaynak: https://the-decoder.com/googles-new-flash-tts-models-let-you-design-ai-voices-from-scratch-using-text-descriptions/